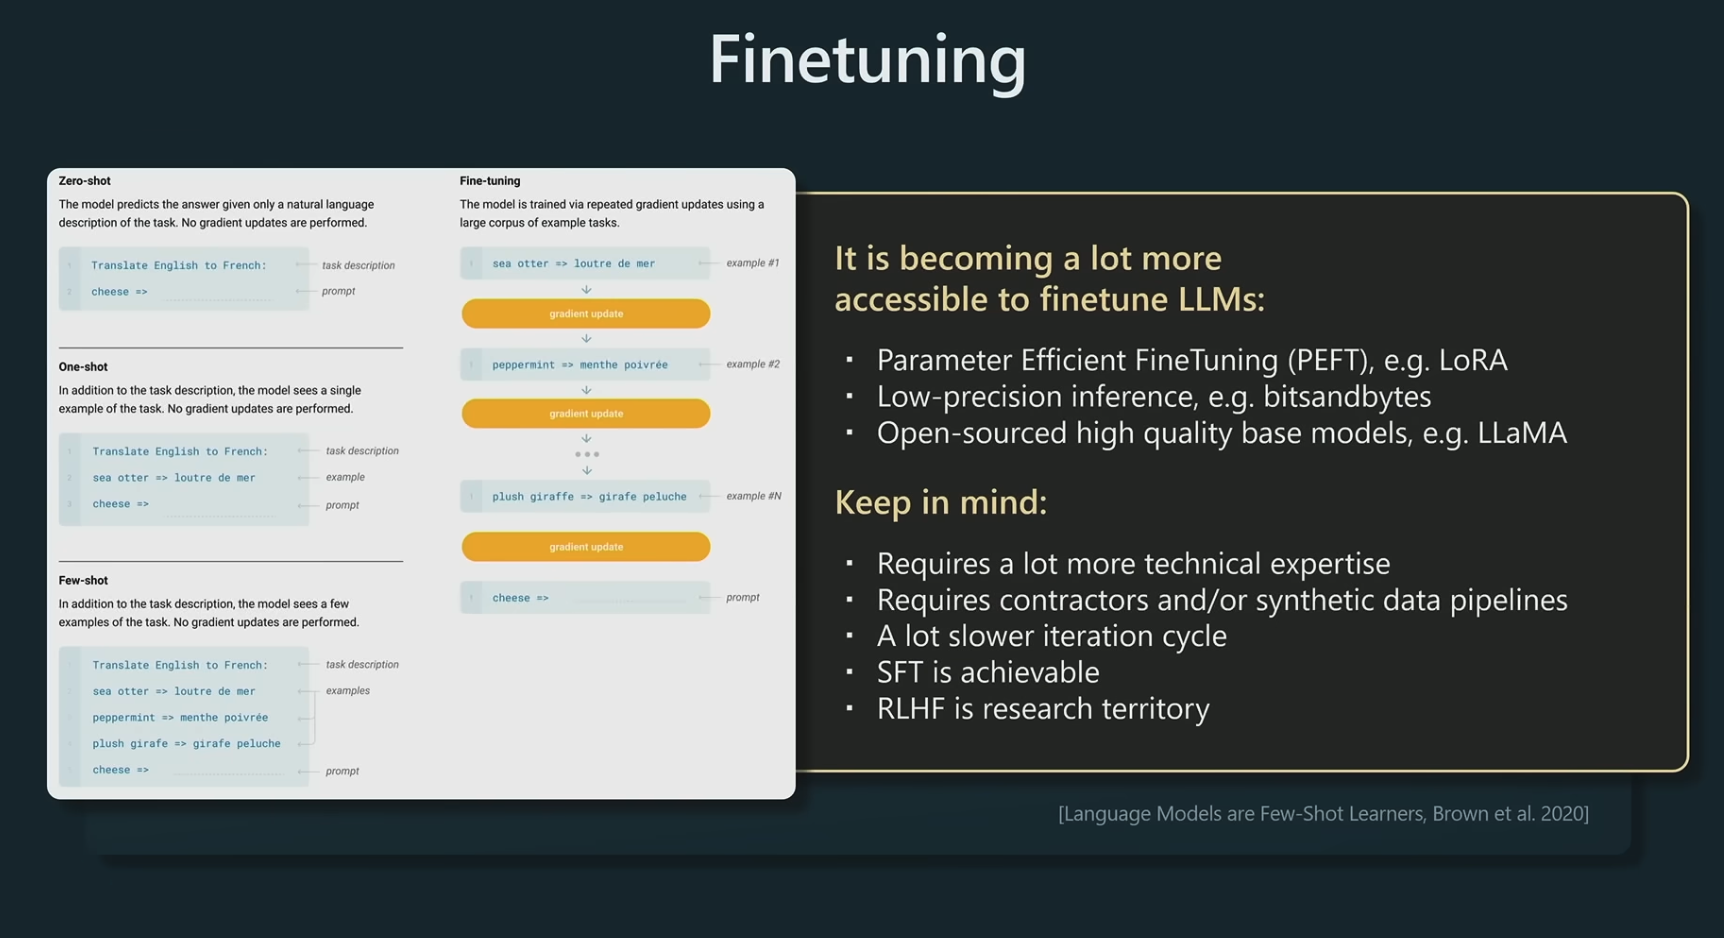
1. 如何训练GPT
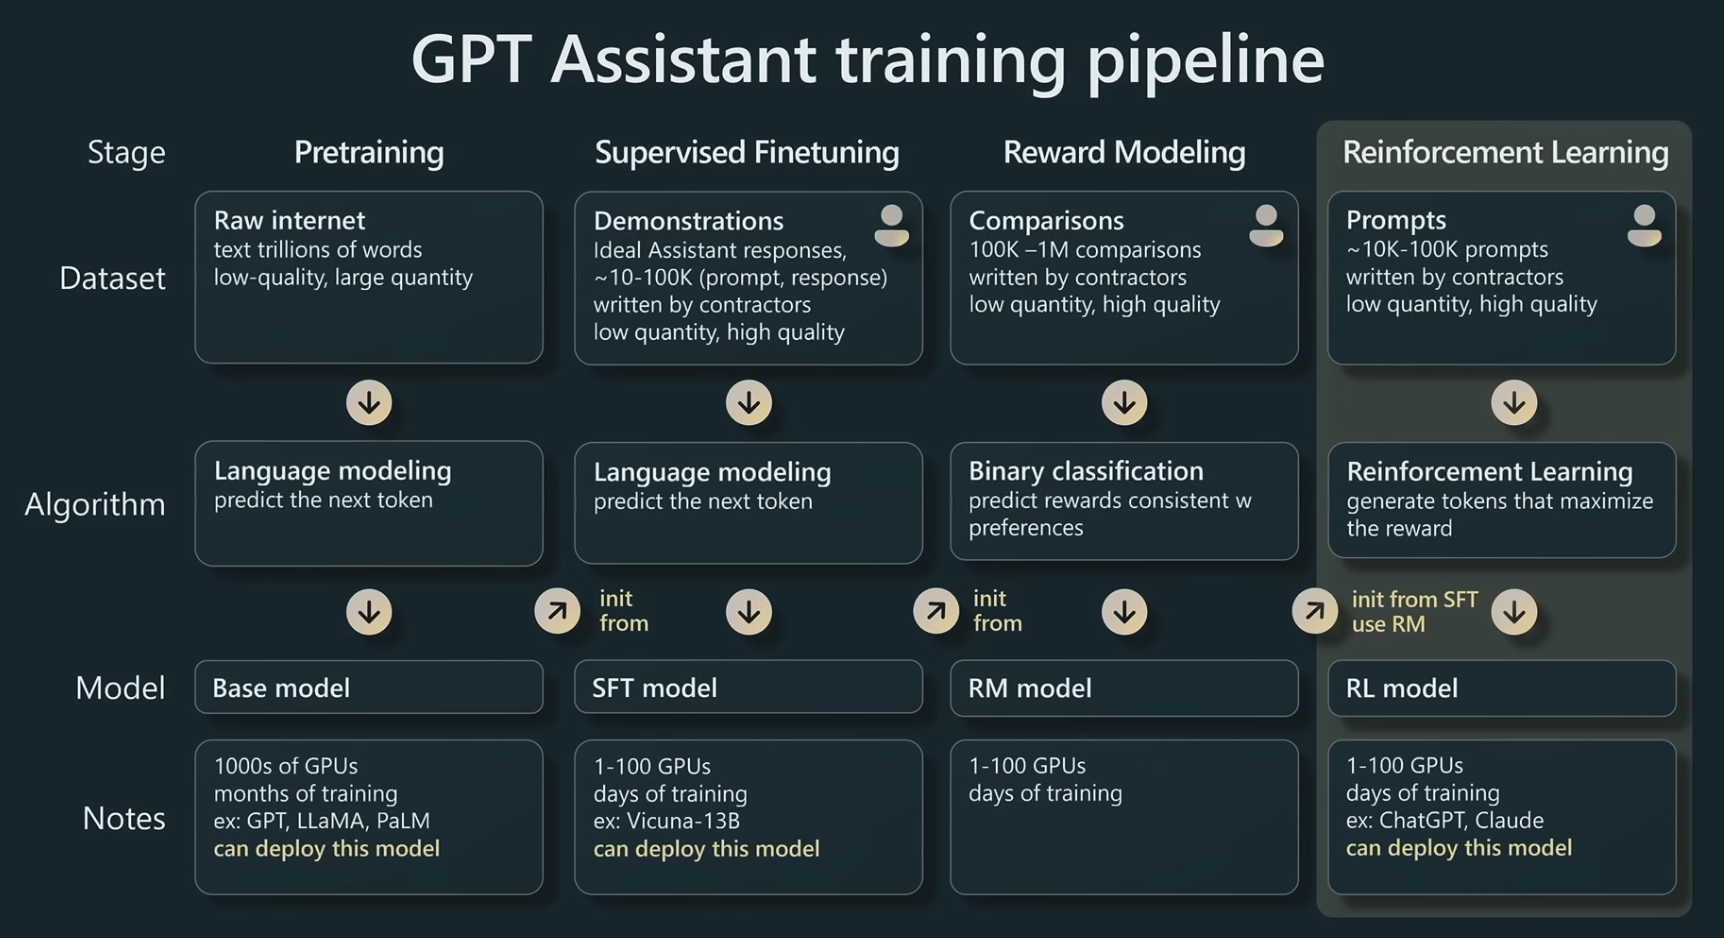
四个步骤:
- 预训练
竞争性工作
- 监督微调
SFL模型
- 奖励建模
RM模型
- 强化学习
RL模型
数据收集
来自arxiv维基百科
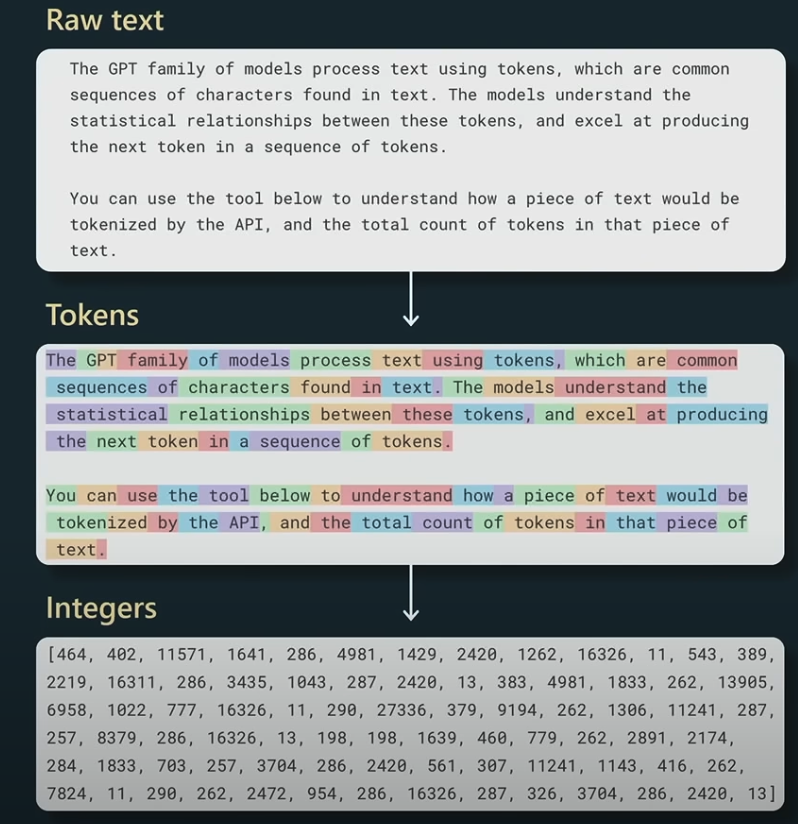
分词处理
将所有文本转换为一长串非常长的整数
以下是示例:
典型算法:字节对编码
字节对编码(BPE)
由于词汇量迅速增加,模型的词汇列表必然会增长到一个非常可怕的数量级。
BPE的主要思想:每一步用一个在数据中未出现的新单元替换最常见的相邻数据单元,反复迭代直到满足停止条件。
以下是示例:
我们得到一个由字母组成的列表"aaabdabaaaac"。第一步是找到最常见的相邻数据单元"aa",并用字母"Z"替换它。因此我们将得到一个由字母"ZabdabZZc"组成的新列表。然后,在第二步,我们将再次重复第一步,并用字母"Y"替换单元"ab"。因此,我们得到一个由字母"ZYdYZZc"组成的新列表。这样我们只需要七个字母就可以表示由十二个字母组成的主列表。
通过使用BPE,我们可以对原始文本进行分词处理。
预训练
训练序列按行排列,以特定的 <|endoftext|> 令牌分隔。
数组的形状是 (B, T)。B 是批量大小,T 是最大上下文长度.
预训练的目标是训练模型能够根据之前的单词预测下一个单词.
这里有一些需要注意的事项:
- 基础模型不回答问题
- 它只想完成互联网文档.
- 但可以通过提示工程将其诱导到执行任务.
监督微调
训练模型以获得从提示中获取理想答案的能力.
SFT
奖励建模
比较模型的输出.
我们可以根据用户获得不同输出的评分。这个过程看似无用,但我们可以将这些评分用于下一步.
强化学习
训练模型预测更接近高分输出的令牌.
RLHF(强化学习人类反馈)变化较少,但基础模型的熵更高。因此这两种类型的模型适合不同任务.
基础模型在您有N个示例并想生成更多事物的任务中表现更好.
2. 如何使用这些系统
GPT就像一个令牌模拟器.
当我们想通过使用CoT来提高GPT的有效性时,模型可能会产生错误的答案,甚至是错误的答案。因此有一个称为自我一致性的方法,它通过集成多个尝试来聚合最终答案.
CoT有很多变种,例如线性CoT或树状CoT.
LLM并不想成功,它们只想模仿!
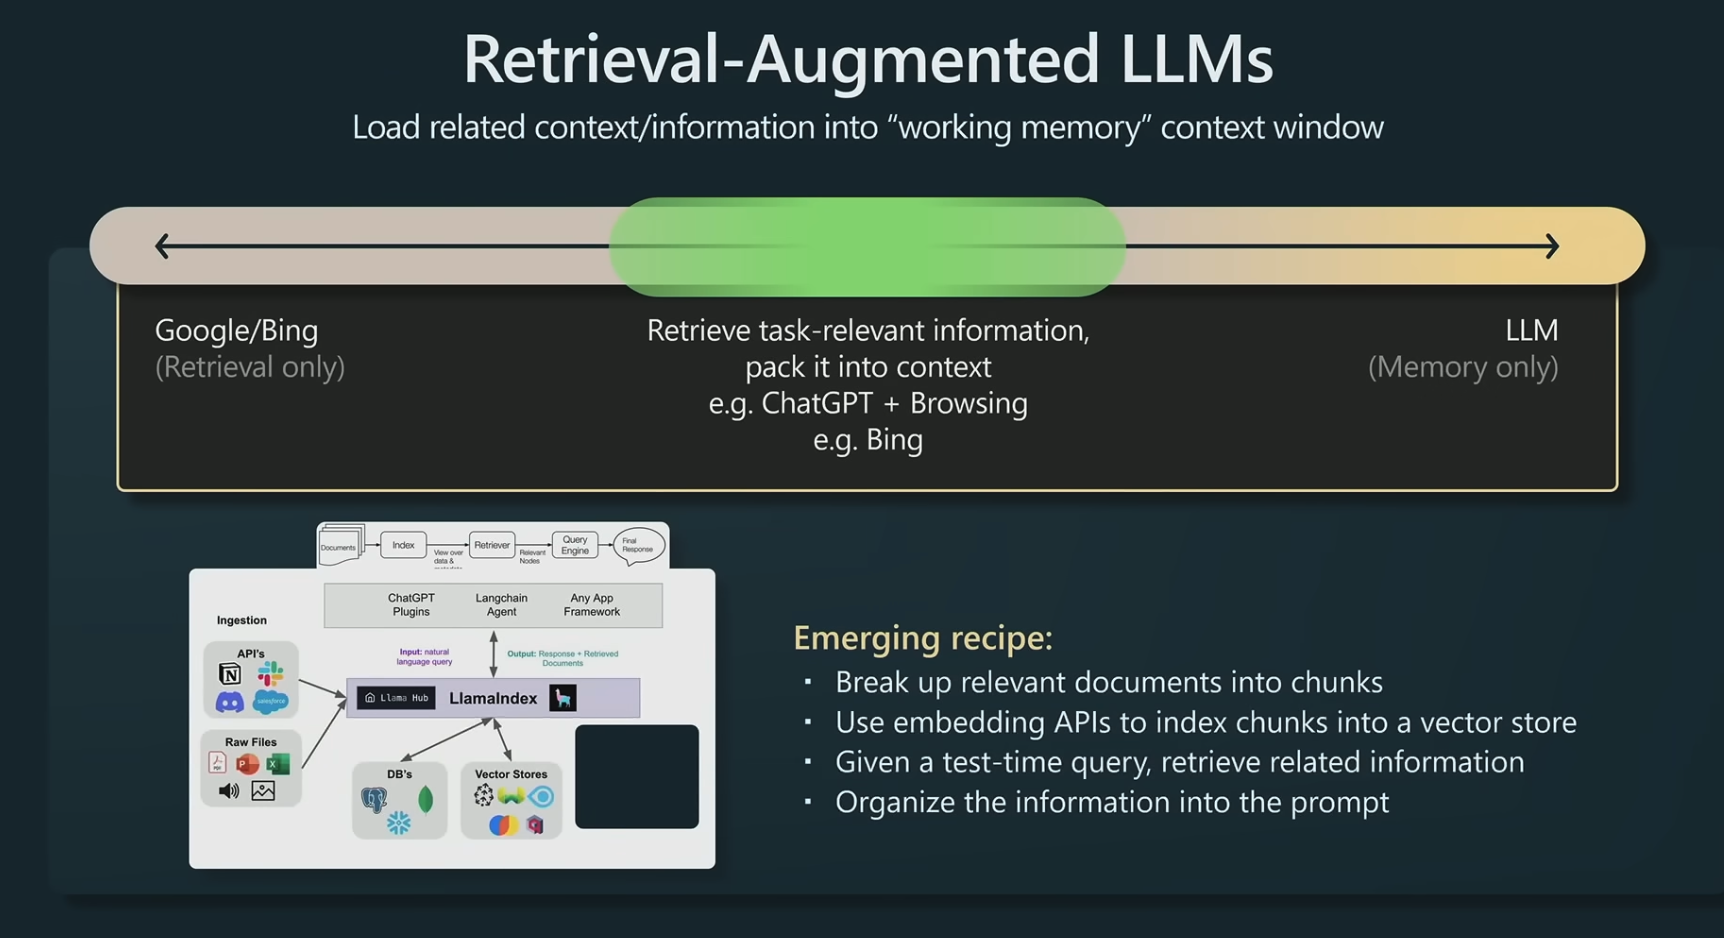
通过这张图片,我们可以意识到我们需要对RAG(检索增强生成)做一些工作.
使用json格式.