
我的总结
这项工作专注于在现实世界和下游自然语言处理任务中使用大型语言模型的实际方面。
因此我们可以将这篇论文视为一本初学者指南,尽管用户可能对大型语言模型不太熟悉。
评估指标
- 自然语言理解 (NLU):增强大型语言模型卓越的泛化能力。
- 生成:生成质量
- 知识密集型任务:有点像微调
- 推理能力:有点像可解释学习?
- 真实场景:实用用途
1. 模型的实用指南
- 仅解码器:GPT-3,BERT
- 编码器-解码器架构:谷歌做出了贡献,这个方向仍然充满希望
三种类型的LLM:
- 非因果注意力语言模型
它们是仅编码器的模型,并采用预测句子中被遮挡词的方式,同时考虑周围的上下文.
在注意机制中,所有输入标记相互可见,这不符合语言的因果性.
代表性模型:BERT和RoBERTa.
- 仅解码模型:GPT风格语言模型
这些模型在架构上通常与任务无关,并且这些方法需要微调在特定下游任务的数据集上.
这些方法是因果注意力语言模型,称为自回归模型.
- 因果注意力语言模型
如何选择LLM架构?
如果任务依赖于捕捉双向上下文,例如命名实体识别或文档分类, 然后 仅编码器模型如 BERT 和 RoBERTa 可能更合适。
如果任务重点是生成文本,例如 翻译或摘要, 那么仅解码器或编码-解码器模型如 GPT 系列和 BART 系列可能更有利。
2. 数据实践指南
- 预训练数据
预训练数据需要一些重要特征:质量、数量以及预训练数据的多样性。
- 微调数据
零标注数据: 在标注数据不可用的情况下,利用 LLM 在零-shot 环境下被证明是最合适的方法。我认为零-shot 学习可以解决 OOD 问题。
例如:模型使用包含马、猫和狗的数据集。然而,任务是识别斑马。所以我们将告诉模型一些特征,
少量标注数据: 这种类型的数据适用于一次性学习或少量学习,也称为 上下文学习.
LLMs 在 数据可用性, 上更具多样性,而微调模型可以考虑 丰富的标注数据。
- 测试数据/用户数据
这些数据集可能包括领域转移、OOD 变化,甚至对抗性示例。利用这些数据,我们可以测试微调和 LLM 模型在实际应用中的有效性。
我们还可以通过强化学习人类反馈来增强模型的泛化能力。
3. NLP 任务实践指南
与传统模型不同, LLM 将标签和输入文本转化为自然语言描述。LLMs 处理这些自然语言输入并直接生成预测,例如标签名称。
- 上下文学习 (ICL)
ICL 不会改变参数。其有效性可能基于诸如 提示模板或上下文示例的选择和顺序。
它类似于少量学习,需要一些示例对和与特定任务相关的查询。
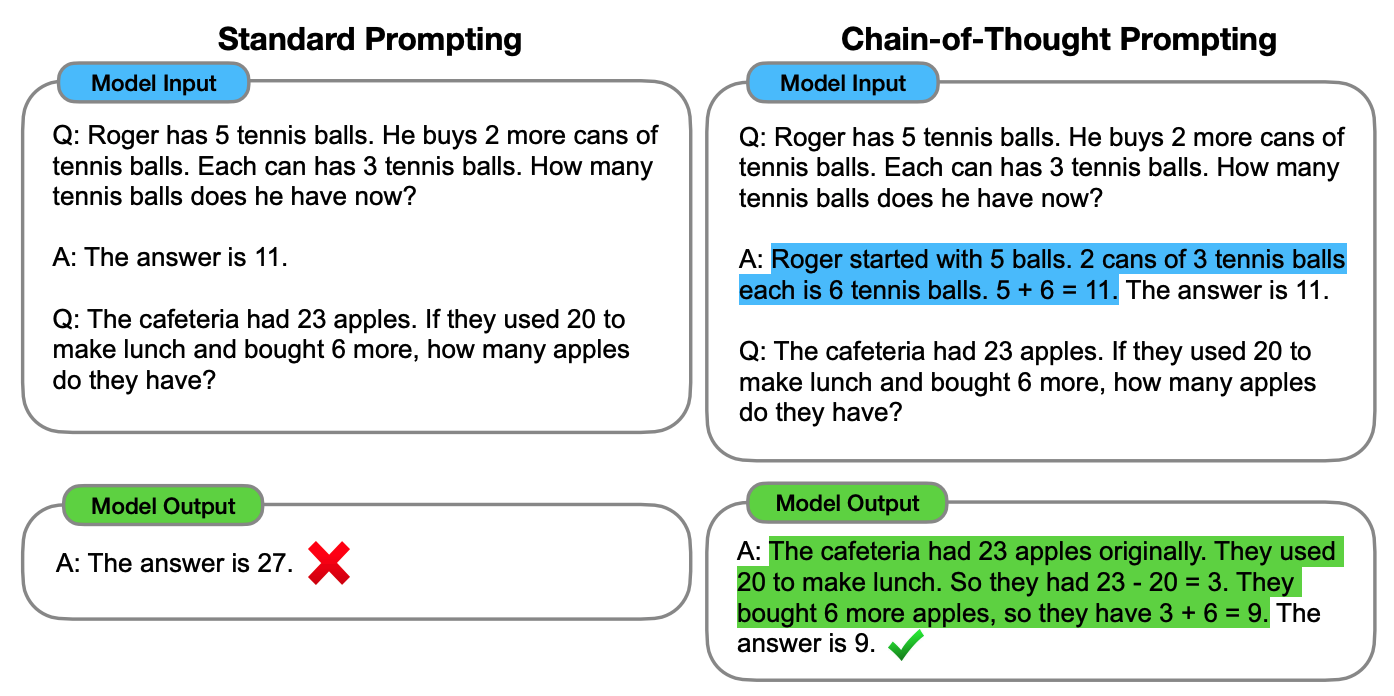
- 思维链 (CoT)
CoT专注于推理过程,其目的是引导LLM学习逐步推理。具体细节见论文[1],我使用此论文中的图片如下:
需要澄清的内容(要点或表达)
1. 对于LLM和微调模型没有普遍认可的定义
在论文中,作者对LLM和微调模型的定义如下:LLM是大型语言模型预训练的在大量的数据集上,没有针对特定任务的调优;微调模型通常是较小的语言模型, 这些模型也是预训练的,然后在较小的任务特定数据集上进一步调优,以优化其在该任务上的性能.
根据这个定义,我有一个问题,LLM和微调模型在某种程度上与知识蒸馏模型中的教师模型和学生模型相似吗?
需要澄清的内容(要点或表达)
1. 对于LLM和微调模型没有普遍认可的定义
在论文中,作者对LLM和微调模型的定义如下:LLM是大型语言模型预训练的在大量的数据集上,没有针对特定任务的调优;微调模型通常是较小的语言模型, 这些模型也是预训练的,然后在较小的任务特定数据集上进一步调优,以优化其在该任务上的性能.
虽然这个定义,我有一个问题,LLM和微调模型在某种程度上与知识蒸馏模型中的教师模型和学生模型相似吗?
附录
- 零样本学习、单样本学习和少样本学习
零-shot学习:基于零-shot学习,该模型可以使用一些辅助信息推断未见类型的信息。
一-shot学习:该方法利用从先前信息中获得的信息来总结特征并推断未见样本。例如,这里有一个需要识别汽车的任务。一-shot学习不是识别特定的汽车,而是确定图像A是否等同于图像B。
少-shot学习:从少量标记示例中学习。
这项工作着重于在现实世界中与LLM合作和下游NLP任务的实际方面。
因此,我们可以将本文视为初学者指南,尽管用户可能对LLM不熟悉。
参考文献
- Wei J, Wang X, Schuurmans D, 等. Chain-of-thought prompting elicits reasoning in large language models[J]. Advances in neural information processing systems, 2022, 35: 24824-24837.